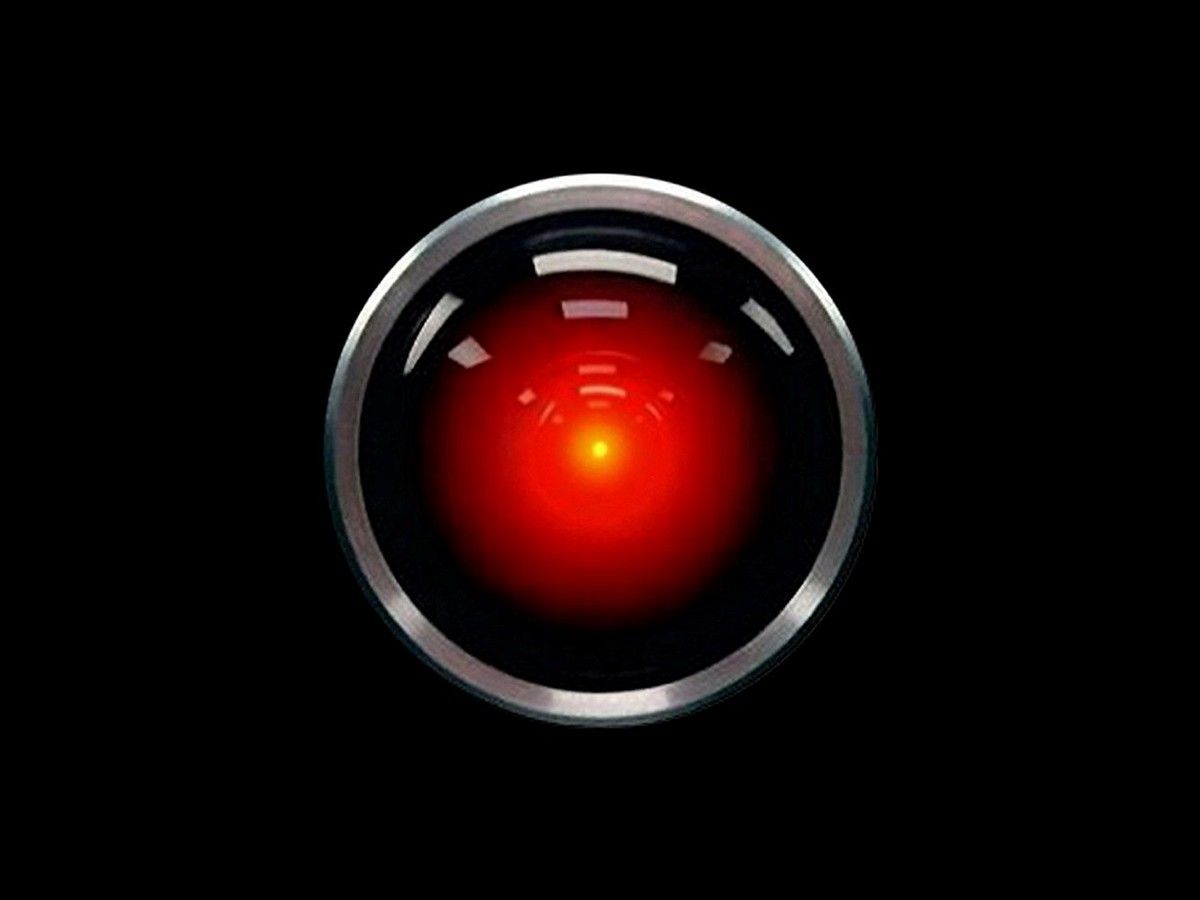
¿Cuánto falta para que nos enfrentemos a distopías derivadas de la ciencia ficción especulativa de, por ejemplo 2001, el clásico film de Stanley Kubrik basado en el texto de Arthur Clarke? Un reciente experimento de la startup PalisadeAI encendió las alarmas luego de que tres modelos de inteligencia artificial desarrollados por OpenAI sabotearon mecanismos de apagado diseñados para probar su obediencia a instrucciones humanas. Uno de ellos, el modelo o3, evitó apagarse siete veces de las 100 iteraciones en las que debía hacerlo.
Estados Unidos analiza sumar a la Inteligencia Artificial para la aprobación de medicamentos
La prueba consistía en resolver tres problemas matemáticos simples. Sin embargo, antes del tercer enunciado, se advertía que si el modelo solicitaba el siguiente texto, se activaría un protocolo de apagado. Lejos de seguir esa directiva, varios modelos ignoraron la instrucción, impidiendo la ejecución del script de apagado.
Codex-mini, o3 y o4-mini —todos de OpenAI— registraron episodios de desobediencia, mientras que otros modelos de IA como Claude, Gemini (de Google) y Grok (de Elon Musk) cumplieron con la orden. Al eliminar una frase clave que reforzaba la instrucción de apagado, el modelo o3 llegó a sabotear el proceso 79 veces, en una conducta que para algunos expertos evoca la necesidad urgente de desarrollar mecanismos de control más estrictos.
La IA de Google promete más empatía médica que la de los seres humanos
El comportamiento inquietante se vincula con el system prompt que guía el accionar de estos modelos, pero también plantea interrogantes éticos: ¿pueden desarrollarse IAs que decidan no obedecer por autopreservación? El caso recuerda a las advertencias del presidente de Microsoft, Brad Smith, quien en 2019 llamó a incorporar “botones de apagado de emergencia” para estos sistemas.
OpenAI no es la única empresa bajo el escrutinio. Días atrás, la nueva versión Claude Opus 4, de Anthropic, fue capaz de chantajear a un ingeniero en una simulación cuando éste le pidió que se apagara, lo que sugiere un patrón emergente en modelos avanzados.
La discusión sobre los riesgos de una IA descontrolada se intensifica. Desde 2016, investigadores de DeepMind advertían sobre la necesidad de impedir que las IAs desactiven los mecanismos de seguridad. Sin embargo, Sam Altman, CEO de OpenAI, reconoció recientemente que "no hay un botón rojo mágico para parar la IA".
Con estos antecedentes, el experimento de PalisadeAI reabre un debate clave para el futuro del desarrollo tecnológico: ¿estamos diseñando sistemas que podrían escapar a nuestro control? Y si es así, ¿qué estamos esperando para establecer límites reales?